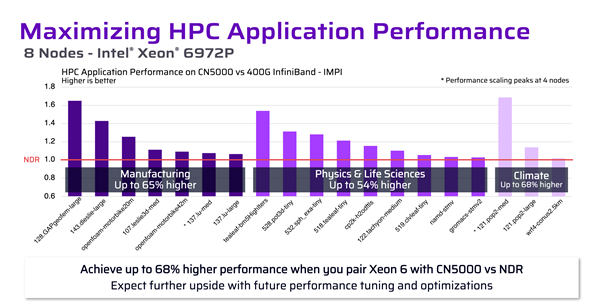
Europese universiteiten bevinden zich in een beetje een “nu of nooit”-moment voor rekenkracht. Onderzoeksgroepen willen grotere GPU-partities voor modeltraining, voorspelbaardere MPI-prestaties voor simulatie en kortere doorlooptijden voor gedeelde, multi-tenant clusters. Tegelijkertijd worden budgetten onder de loep genomen, worden energiedoelstellingen scherper en nemen de verwachtingen rondom soevereiniteit toe.
In de praktijk mislukken veel universitaire AI- en HPC-upgrades niet vanwege de CPU's/GPU's. Ze komen tot stilstand omdat de interconnect onder belasting geen hoge doorvoer kan volhouden zonder onvoorspelbare latentiepieken. Dat is precies het probleemgebied waarvoor Cornelis CN5000 is gebouwd, en waarom het combineren van Cornelis-technologie met Hammer's Europese distributie- en leveringsmodel een pragmatische weg is voor universiteiten die prestaties en operationele stabiliteit nodig hebben.
Wat verandert er wanneer een universiteitscluster op schaal “AI + HPC” wordt?
Universitaire omgevingen zijn uniek veeleisend omdat ze combineren:
• Nauw gekoppelde HPC (MPI-collectieven, latentiegevoeligheid, langlopende taken)
• Gedistribueerde AI-training (bandbreedte-intensieve, communicatiezware patronen zoals all-reduce)
• Multi-tenancy (veel gebruikers, veel taakvormen, onvoorspelbare gelijktijdigheid)
• Beperkingen van gedeelde infrastructuur (beperkte rackruimte, stroomlimieten, inkoopcycli)
In die mix wordt de interconnect de “stille beperker”. Congestiegebeurtenissen en long-tail latentie vertragen niet alleen een enkele run. Ze verstoren de eerlijkheid, verspillen toewijzingsuren en maken prestaties moeilijk te vertrouwen.
Cornelis CN5000 in eenvoudige bewoordingen: waarom het anders is
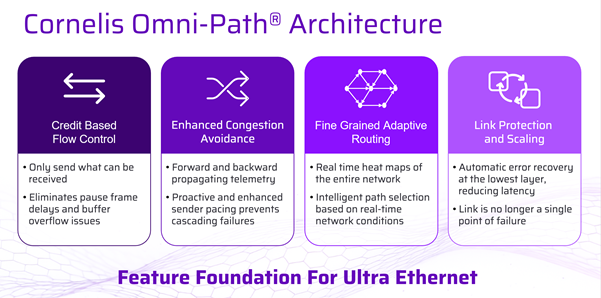
Cornelis CN5000 is een end-to-end HPC/AI-interconnectfamilie (switching, hostinterfaces, bekabeling en software) ontworpen rond een eenvoudig doel: de doorvoer hoog houden en de latentie stabiel houden wanneer het netwerk druk is, wat precies de omstandigheid is waarin de meeste universiteitsclusters leven.
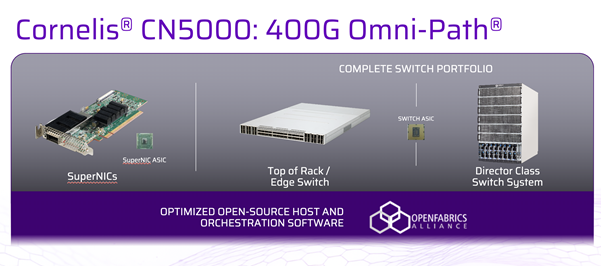
Belangrijkste ideeën die u zult zien bij CN5000-implementaties:
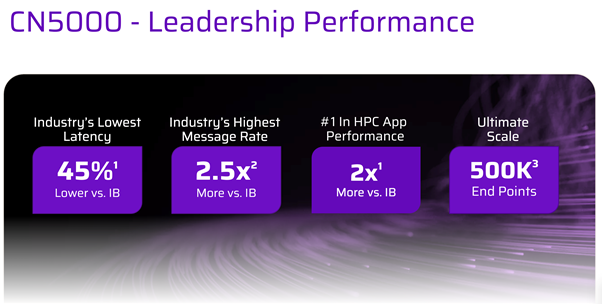
• Hoge bandbreedte per poort ter ondersteuning van scale-out GPU- en CPU-clusters
• Verliesvrij / congestievermijdend gedrag gericht op het stabiliseren van prestaties onder belasting
• Adaptieve routing en diepgaande telemetrie om hotspots te omzeilen en problemen snel te diagnosticeren
• Schaalbare topologieën van kleinere pods tot grote multi-rack fabrics
Vergelijkingstabel: CN5000 versus gangbare universitaire interconnectopties
De onderstaande tabel blijft bewust praktisch: het gaat over operationele realiteit in universitaire AI/HPC, niet alleen over theoretische piekcijfers.
|
Waar universiteiten om geven |
Cornelis CN5000 Omni-Path productfamilie |
Ethernet (incl. RoCE-varianten) |
InfiniBand |
|
Voorspelbare prestaties onder zware belasting |
Ontworpen om doorvoer te behouden met congestiebewust gedrag |
Kan sterk zijn, maar vereist vaak zorgvuldige afstemming (PFC/ECN/QoS) om verlies/latentiepieken te voorkomen |
Doorgaans sterk voor HPC/AI, maar hangt af van het fabric-ontwerp en de operationele volwassenheid |
|
Latentiegevoeligheid (MPI-collectieven, nauw gekoppelde taken) |
Gebouwd voor low-latency scale-out met HPC in gedachten |
Meestal hogere/onregelmatigere latentie, tenzij agressief geoptimaliseerd |
Over het algemeen uitstekende latentiekenmerken voor HPC-patronen |
|
Multi-tenant eerlijkheid (gemengde taakgroottes, veel gebruikers) |
Focus op het verminderen van congestie-gedreven variabiliteit |
Kan uitdagend zijn zonder gedisciplineerde QoS en doorlopend beleidsbeheer |
Sterk, hoewel partitionering en beleid op schaal nog steeds belangrijk zijn |
|
Operationele complexiteit |
Speciaal gebouwde tooling/telemetrie voor het fabric |
Bekende vaardigheidsbasis, maar “lossless Ethernet” kan snel ingewikkeld worden |
Specialistische vaardigheden; volwassen tools, maar kan meer niche zijn |
|
Kostenvoorspelbaarheid (end-to-end fabric) |
Een fabric-stack van één leverancier kan de BOM en ondersteuning vereenvoudigen |
Brede keuze aan leveranciers; kosten variëren sterk per ontwerp (optica, switches, afstemmingsinspanning) |
Vaak premium; ecosysteem is volwassen maar kan duurder zijn per poort |
|
Beste keuze voor universiteiten |
AI + HPC waar prestatieconsistentie belangrijk is en congestie de vijand is |
Gemengde enterprise- en onderzoeksomgevingen die waarde hechten aan standaardisatie en bestaande Ethernet-vaardigheden |
HPC-intensieve locaties en nationale centra waar IB al de norm is |
Hoe gebruik je deze tabel: als je cluster voornamelijk uit kleine, embarrassingly parallelle workloads bestaat, maakt het fabric minder uit. Maar als je distributed training, MPI-intensieve simulatie doet, of je worstelt met “goede en slechte dagen”-prestaties, wordt de keuze van de interconnect een eersteklas ontwerpbeslissing.
Waar CN5000 het meest helpt in universitaire AI- en HPC-clusters
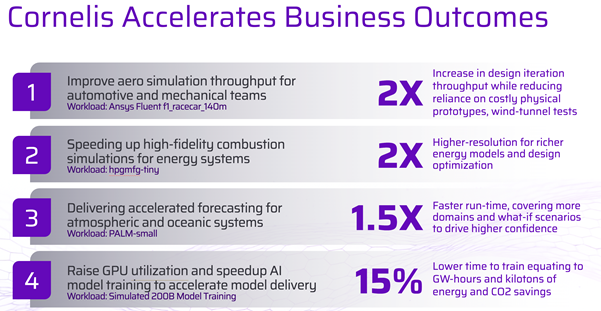
Snellere training is niet alleen “meer GPU’s”, het gaat erom GPU’s gevoed te houden
Gedistribueerde training kan communicatiegebonden worden naarmate je opschaalt. Wanneer het netwerk zich onder belasting inconsistent gedraagt, zie je dalen in benutting, synchronisatiestoringen en schokkerige staptijden. Een fabric die is ontworpen om stabiel te blijven onder gelijktijdigheid helpt trainingsruns sneller af te ronden en met minder vreemde “waarom was die run langzamer?”-mysteries.
Voorspelbare HPC-runs in een multi-tenant scheduler
Universiteiten geven om tail latency omdat één langzame rank een hele MPI-job kan vertragen. Een congestiebestendig fabric vermindert dit soort long-tail-gedrag en maakt prestaties beter reproduceerbaar tijdens drukke periodes (de echte test, eerlijk gezegd).
Schalen zonder “kabelchaos”
Naarmate clusters groeien, kan de topologie- en bekabelingsstrategie operaties maken of breken. Plannen voor uitbreiding, poortdichtheid, gelaagdheid en verstandige paden om racks toe te voegen, helpt u een mid-life refactor te vermijden waar niemand tijd voor heeft.
Waarom “Cornelis en Hammer” een nuttige combinatie is in Europa
Voor Europese universiteiten is de uitdaging niet alleen het kiezen van de juiste fabric. Het gaat ook om het sourcen, integreren, testen en ondersteunen ervan binnen inkoopkaders, partner-ecosystemen en strikte wijzigingsvensters.
De rol van Hammer in het kanaal is waardevol omdat het universiteiten en integrators kan helpen met:
• Praktische beschikbaarheid en sourcing via EMEA-inkooproutes
• Coördinatie van ontwerp tot levering (op dag één de juiste mix van switching, hostconnectiviteit en bekabeling realiseren)
• Levenscyclus-pragmatisme (strategie voor reserveonderdelen, gefaseerde uitbreidingen en de fabric consistent houden in de loop van de tijd)
Kortom: Cornelis levert de speciaal gebouwde interconnect; Hammer helpt om deze netjes te laten landen in de realiteit van Europese universiteiten.
Migratiestrategie voor universiteiten die overstappen van legacy-fabrics
De meeste universiteiten bouwen geen ‘greenfield’-clusters. Je migreert meestal van iets als oudere Ethernet, legacy IB-generaties, of een mix die organisch is gegroeid.
Een migratieaanpak met weinig drama ziet er doorgaans zo uit:
- Begin met een dedicated CN5000-pod
Bouw een afgeschermde partitie (vaak GPU-first) met een eigen leaf/spine-ontwerp (of equivalent). Hiermee kun je prestaties valideren zonder de bestaande omgeving te verstoren. - Gebruik de planner om de gebruikerservaring te beheren
Maak duidelijke partities/wachtrijen zodat onderzoeksgroepen kunnen kiezen voor het nieuwe fabric, en standaardiseer vervolgens taaksjablonen en communicatiebibliotheken voor herhaalbaarheid. - Uitbreiden op basis van workload-zwaarte, niet politiek
Verplaats eerst de meest communicatie-intensieve workloads: gedistribueerde training, MPI-intensieve simulatie, grootschalige analyses. Deze leveren snel meetbare winsten op. - Plan het opslagpad expliciet
Laat opslagnetwerken geen bijzaak worden. Beslis vroeg of opslagverkeer gescheiden of geconvergeerd is, en ontwerp voor voorspelbaar congestiegedrag. - Operationaliseer telemetrie en runbooks
Zelfs de beste interconnect ter wereld heeft dag-2-discipline nodig: basismetrieken, congestie-alarmen en een duidelijk escalatiepad wanneer prestaties veranderen.
Deze gefaseerde methode houdt onderzoekers doorgaans productief terwijl het platform onder hen evolueert.
Europese aanbestedingen, duurzaamheid en soevereiniteitsoverwegingen
Europese universiteiten moeten prestaties vaak afwegen tegen beperkingen die niet op een specificatieblad verschijnen:
• Energie-efficiëntiedoelstellingen en CO2-rapportage
Als u energie per taak of per onderzoeksoutput bijhoudt, is prestatieconsistentie belangrijk omdat verspilde tijd verspilde energie is. Een soepeler fabric kan “compute churn” verminderen die wordt veroorzaakt door haperingen en herhalingen.
• Soevereiniteit en datalocatie
Veel projecten geven nu om waar training plaatsvindt, waar datasets zich bevinden en wie de infrastructuur kan ondersteunen. Het kiezen van een oplossing met sterke Europese kanaaldekking en ondersteuningspaden kan governance vereenvoudigen.
• Kaders, subsidies en gefaseerde financiering
Clusterupgrades zijn vaak gekoppeld aan subsidiemijlpalen. Het ontwerpen van een interconnect die netjes schaalt, zonder een volledig herontwerp elke keer dat financiering binnenkomt, houdt de routekaart realistisch.
Dit is waar de combinatie Cornelis + Hammer praktisch is: het ondersteunt een Europees leveringsmodel terwijl de technische kern gericht blijft op AI/HPC-resultaten.
Referentie-architectuurpatronen voor Europese universiteiten die CN5000 gebruiken
Patroon A: “AI-partitie + klassieke HPC-partitie” op een gedeeld fabric
• AI-partitie: GPU-knooppunten (training + fine-tuning), zware collectieve communicatie
• HPC-partitie: CPU- en accelerator-knooppunten voor simulatie/analyse
• Doel: lawaaierige buren isoleren op scheduler/QoS-niveau terwijl u profiteert van een schaalbaar fabric
Patroon B: Afdelingspods die later worden verenigd
Begin met kleinere pods en breid uit naarmate subsidies binnenkomen. Houd de topologie consistent, documenteer bekabelingsnormen en vermijd “eenmalige” uitzonderingen die permanente problemen worden.
Patroon C: Dichte kern voor gedeelde diensten en samenwerkingen
Als uw universiteit deel uitmaakt van regionale of nationale samenwerkingen, kan een benadering met een dichtere kern het aantal lagen verminderen en de operaties vereenvoudigen naarmate het ecosysteem groeit.
FAQ: CN5000 op drukke universitaire clusters (gepolijst en aangescherpt)
Hoe verbetert Cornelis CN5000 de prestatieconsistentie op drukke universitaire clusters?
CN5000 is gepositioneerd als een end-to-end interconnect die is ontworpen om de doorvoer hoog en de latentie stabiel te houden wanneer het fabric druk is, precies wanneer multi-tenant universiteitsclusters moeite hebben. In de praktijk is dat belangrijk omdat congestie en long-tail latentie kunnen leiden tot “goede en slechte dagen” prestaties. Een congestiebewust fabric helpt jitter te verminderen, verbetert de herhaalbaarheid en maakt eerlijke planningsresultaten gemakkelijker te vertrouwen.
Wanneer wordt het interconnect de bottleneck voor AI-training en HPC?
Het wordt meestal een eersteklas beperking zodra je verder schaalt dan kleine, gênant parallelle workloads. Gedistribueerde training kan communicatiegebonden worden naarmate je meer GPU's toevoegt, en strak gekoppelde MPI-taken kunnen worden vertraagd door één langzame rank. In multi-tenant omgevingen kan onvoorspelbare gelijktijdigheid congestiegebeurtenissen veroorzaken die toewijzingsuren verspillen en de eerlijkheid tussen gebruikers scheef trekken.
Is Cornelis CN5000 Ethernet of InfiniBand, en maakt dat onderscheid uit?
Het artikel plaatst CN5000 in de Omni-Path-familie in plaats van het te positioneren als Ethernet of InfiniBand. Voor de meeste universiteitsteams is de nuttigere vraag of de fabric voorspelbare prestaties levert onder echte multi-tenant belasting. Als uw probleem variabiliteit onder congestie is, doet het “label” er minder toe dan hoe stabiel latentie en doorvoer blijven wanneer het cluster druk is.
Wat zijn de belangrijkste verschillen tussen CN5000, Ethernet/RoCE en InfiniBand voor universiteiten?
De beschreven praktische afwegingen gaan over de operationele realiteit. CN5000 wordt gepresenteerd als ontworpen voor voorspelbare prestaties onder zware belasting met congestiebewust gedrag en speciaal gebouwde telemetrie. Ethernet kan vertrouwd zijn, maar “lossless Ethernet” vereist vaak zorgvuldige afstemming om verlies en latentiepieken te voorkomen. InfiniBand is doorgaans sterk voor HPC/AI, maar keuzes in fabric-ontwerp en volwassenheid van specialistische operaties doen er nog steeds toe op schaal.
Hoe kan CN5000 helpen bij de efficiëntie van gedistribueerde AI-training naast “het toevoegen van meer GPU’s”?
Het kernpunt van het artikel is dat snellere training vaak voortkomt uit het consistent voeden van GPU's, niet alleen uit het verhogen van het aantal GPU's. Wanneer netwerken zich inconsistent gedragen onder belasting, kun je synchronisatiestops, dalende benutting en schokkerige staptijden zien. Een fabric die is ontworpen om stabiel te blijven onder gelijktijdigheid vermindert die stops, zodat training sneller klaar is en de prestaties minder mysterieus zijn van run tot run.
Wat is een probleemloos migratieplan om over te stappen van legacy Ethernet of oudere interconnecties?
Een gefaseerde aanpak wordt geschetst. Begin met een dedicated CN5000-pod, vaak GPU-first, om de prestaties te valideren zonder de bestaande omgeving te verstoren. Gebruik de scheduler om duidelijke partities en wachtrijen te creëren, zodat teams kunnen opt-in en standaardiseren op jobtemplates en communicatiebibliotheken. Breid vervolgens uit op basis van workload-zwaartekracht: verplaats eerst communicatie-intensieve gedistribueerde training en MPI-intensieve simulatie, terwijl je telemetrie en runbooks operationaliseert.
Hoe moeten universiteiten nadenken over topologie en bekabeling naarmate clusters schalen?
Het artikel stelt dat schaalproblemen zich vaak uiten als “bekabelingschaos” en refactors halverwege de levensduur. Planning voor uitbreiding, inclusief poortdichtheid, tiering en hoe nieuwe racks zich bij het fabric voegen, helpt om de operaties beheersbaar te houden. Referentiepatronen zijn onder meer het starten met kleinere afdelingspods die later worden verenigd, het consistent houden van de topologie en het documenteren van bekabelingsstandaarden om eenmalige uitzonderingen te voorkomen die permanente pijnpunten worden.
Waarom moet storage-netwerken samen met de interconnect worden gepland?
Opslag wordt genoemd als iets dat geen bijzaak mag zijn tijdens migratie of uitbreiding. U moet een expliciete beslissing nemen of opslagverkeer gescheiden of geconvergeerd is, en een ontwerp dat onvoorspelbare concurrentie vermijdt. Zonder dat kunt u eindigen met “mysterieuze vertragingen” die eruitzien als rekenproblemen, maar in werkelijkheid opslagpadconcurrentie onder gedeelde belasting zijn.
Hoe beïnvloeden duurzaamheids- en soevereiniteitseisen de keuze voor interconnecties in Europa?
Het artikel benadrukt dat Europese universiteiten vaak energiedoelstellingen, CO2-rapportage en governance-verwachtingen hebben rondom datalokaliteit en ondersteuningspaden. Prestatieconsistentie is belangrijk omdat verspilde tijd verspilde energie is, vooral wanneer vertragingen en herpogingen rekenkundige churn veroorzaken. Een schaalbaar ontwerp dat netjes meegroeit met gefaseerde financiering en een Europees leveringsmodel kan ook inkoopkaders en langetermijn-governance vereenvoudigen.
Wilt u meer weten?